python web容器的子解释器兼容性扩展
从python 3.12开始,子解释器拥有独立的GIL和内存分配器,这表明在同一个进程内,python可以利用多核处理器的优势,代码可以真正的并行处理
正好我自己有个想法,就是现在的web框架都是面向生产的,安装配置要么繁琐、要么编译时间长、要么体积大,我在想有没有一个类似php的项目,把脚本丢上去就能跑的
但是我不喜欢php,php还是相对比较重型的技术,通常要搭配apache、nginx这样的中间件,要编译部署两个程序,有点麻烦
所以之前用AI做了个web容器,链接在这
vibe coding C++ 实现 python web 容器 - zgbsm’s note
但是子解释器模式并非完美,这东西有坑
python在设计上是解释器之间必须做好隔离,因为每个解释器的GIL是独立的,共享变量容易出现并发控制问题,而且内存回收也不好处理;这就导致一些依赖包无法正常运行,因为有的传统依赖包会在当前import的那个解释器初始化内存,但是其他解释器没有初始化,这样就会出现问题
关于启动子解释器运行py文件,目前python有2个方式:1.所有子解释器共享1个内存分配器,但是也要共享GIL,没有兼容性问题(默认方式);2.每个子解释器用自己的内存分配器,独立GIL,存在部分依赖包的兼容性问题
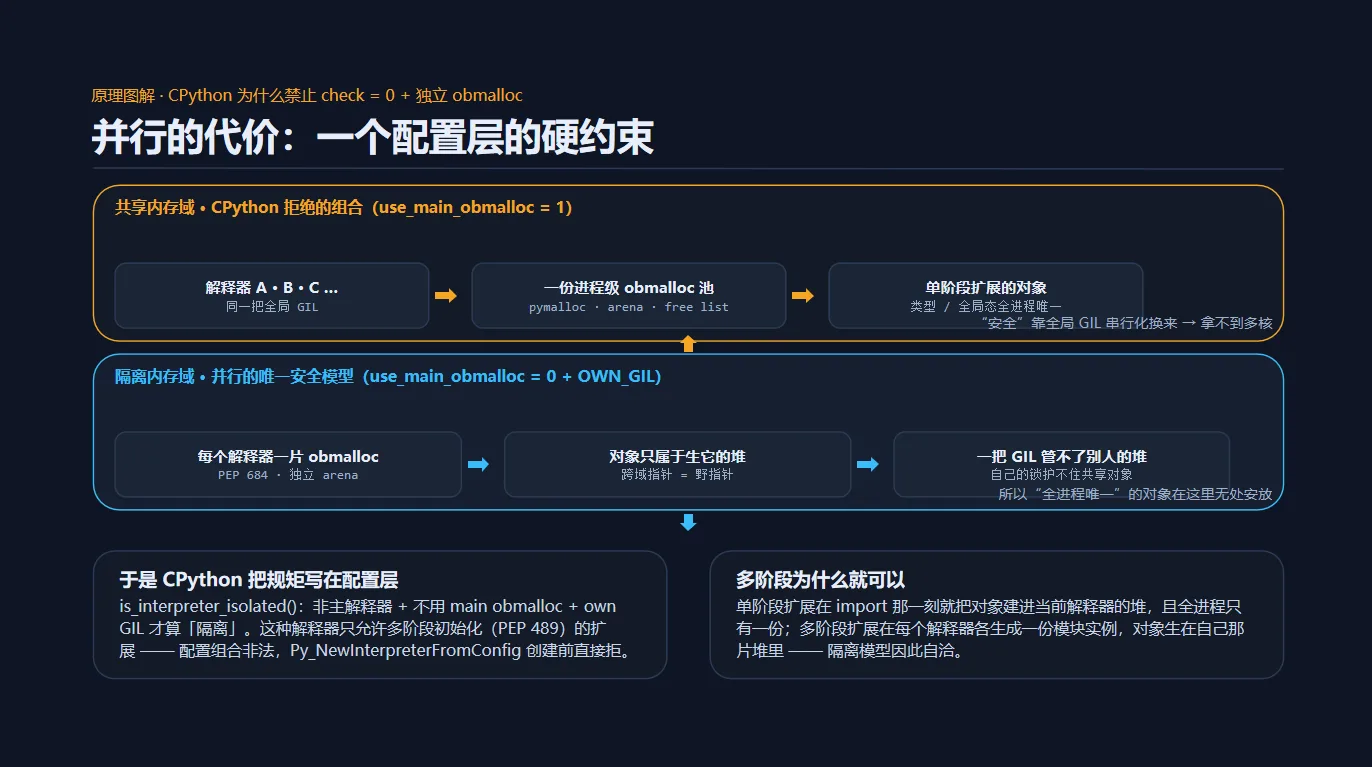
在这里不可能使用方案1,毕竟如果项目比较大,总有一两个依赖是不兼容的;因此只能想办法隔离不兼容的依赖,比如把这些依赖固定在单独的解释器上,然后跨解释器调用这些依赖的功能
跨解释器调用其实也是一个很麻烦的事情,因为这涉及到参数传递
参数传递有几种方案,1是拷贝传参,2是引用传参,3是所有权转移传参。刚才也提到说,每个解释器的内存分配是独立的,内存回收也是独立的
拷贝传参没什么问题,但是有些python对象在C语言层面是指针,这就只能进行深拷贝处理,实际开销跟序列化传输差不多
引用传参不可行,因为这违反了python的隔离设计,一旦相同的内存跨越GIL引用,会出现并发竞争问题
所有权转移也不行,因为每个解释器的内存回收是独立的,直接将变量挪过去会出现内存管理问题,如果将引用计数等内存管理数据一起挪过去就太复杂了,涉及到python原生内存管理功能的改动,容易埋下隐藏bug,不划算
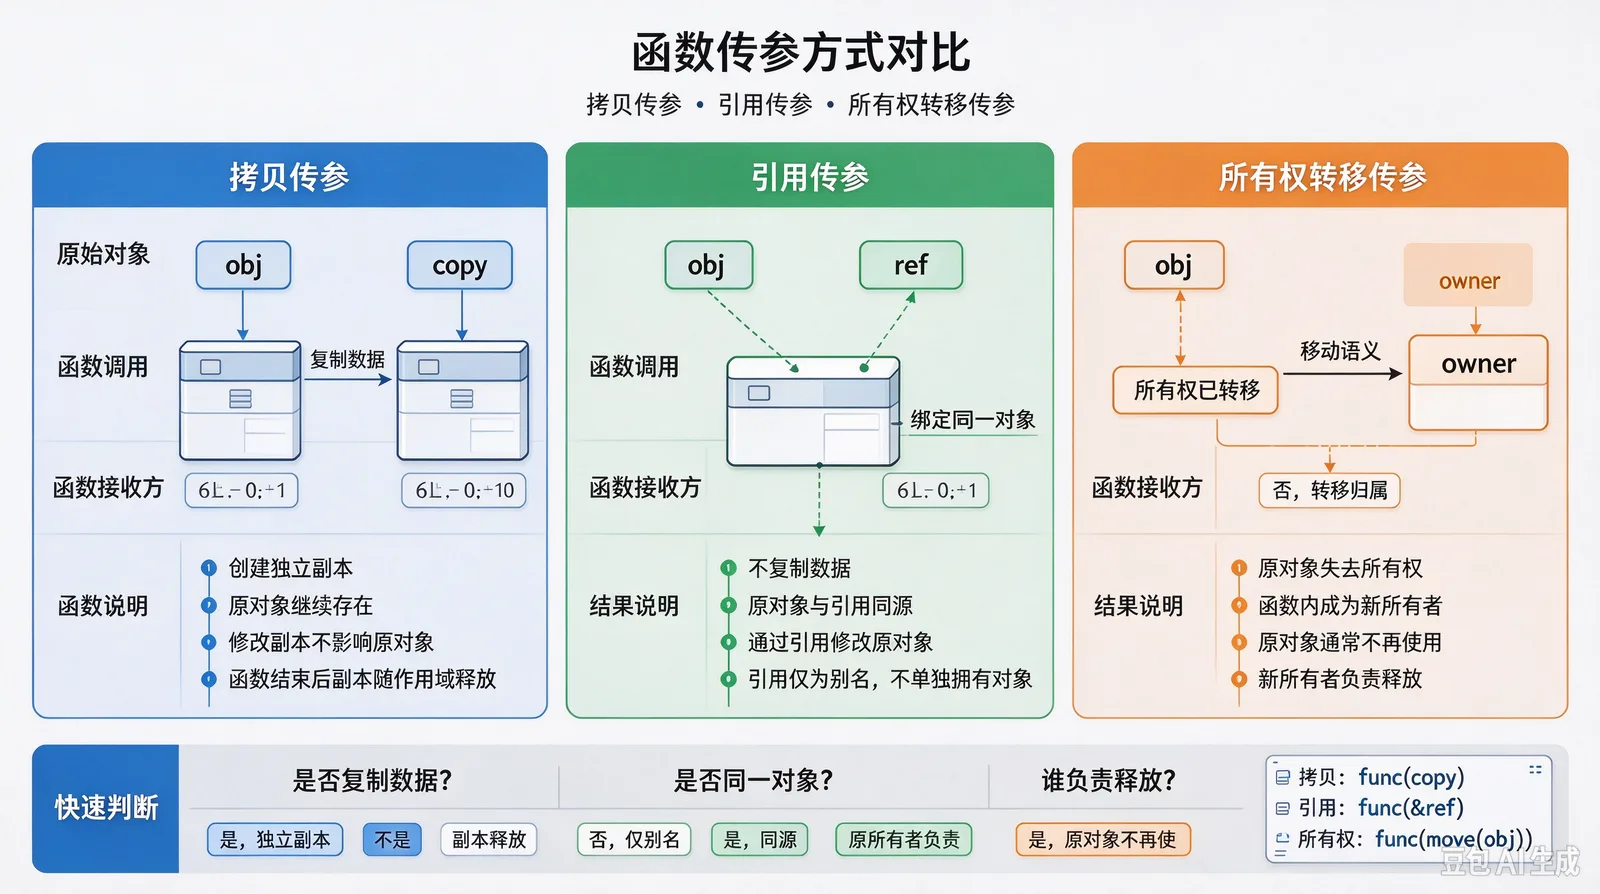
那么最后只能拷贝传递参数了,将解释器的内存数据拷贝出来塞到另一个解释器里,这里的开销稍微有点大,毕竟要将python对象的引用的内存全都要拷贝出来,还要编排好格式发过去,接收参数的解释器也要开内存去创建python对象;有点像序列化/反序列化了
欸,说到反序列化,那跨进程通信的开销是否也可接受呢?因为单独启动一个解释器用来跑不兼容的依赖还是有点抽象,对于开发者来说心智负担比较重,在写业务代码的时候要学习新概念,容易出岔子
让AI评估了一下,其实开销不会差很多,进程间通信这块AI推荐用unix套接字,比较简单不容易出bug,于是决定专门启动一个进程用来运行不兼容子解释器模式的依赖
可是这里又出了一个新的问题,运行在专用进程上的依赖会成为整个项目的性能瓶颈,当前我这个web容器在设计时并没有使用异步io那一套,当专用进程上任务排队时,子解释器池很快就用尽了,整个系统的性能会掣肘于专用进程的效率,然后性能降级为单线程级别,这种情况下多解释器的优势又没有了
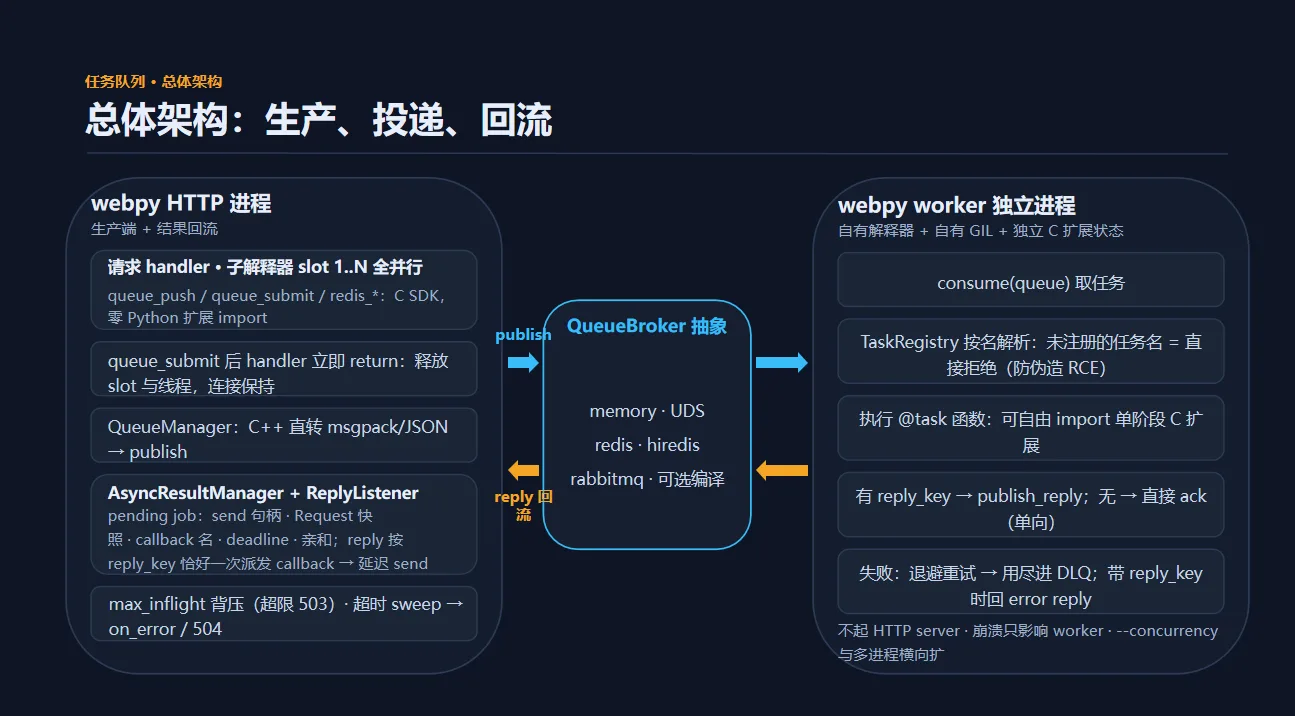
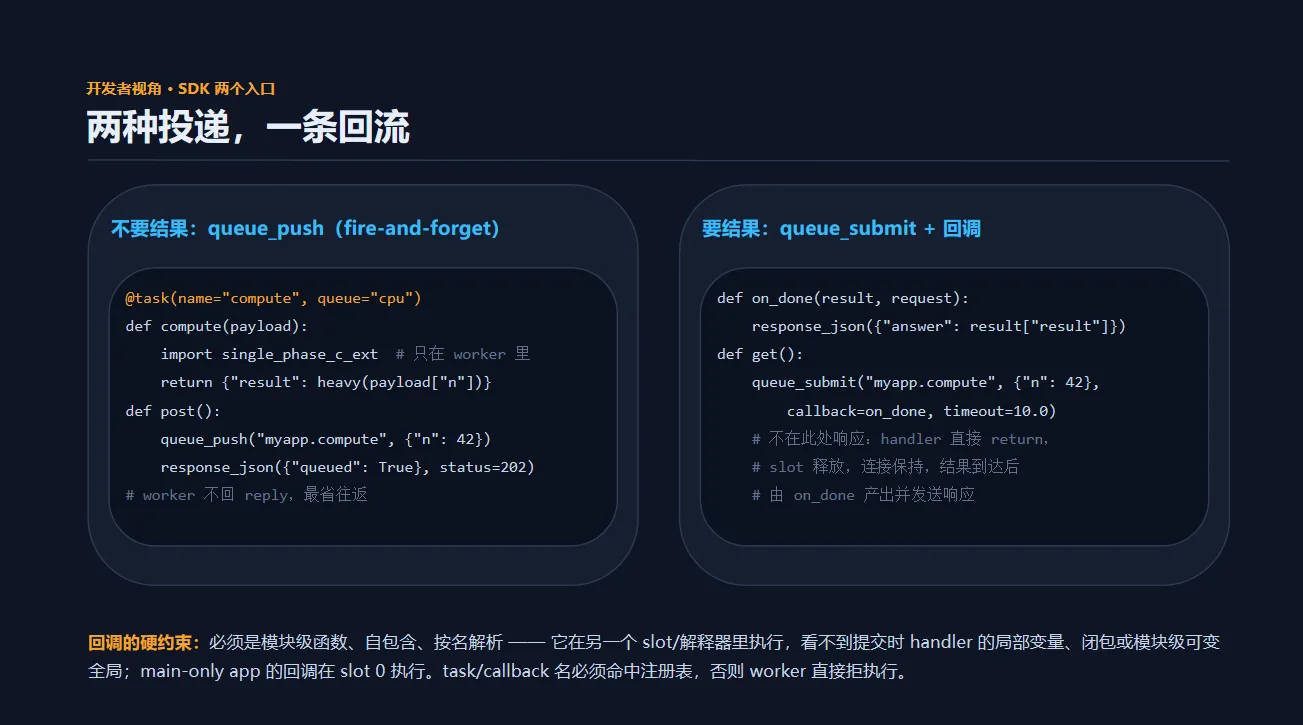
因此这里考虑引入队列机制,给这个web容器新增一个队列功能,在应用开发时将跨进程调用的任务放入队列,然后不阻塞直接向后运行,等到排队结束之后将任务的执行结果直接传入回调函数,开发体验有点像js的Promise,顺便还能让web容器支持异步任务,感觉非常美味
初步想法是只做本地队列,但是做都做了,干脆也支持一下redis队列和rabbitmq队列吧,那redis队列都做支持了,不如把redis客户端也顺手实现了。下面这张图就是任务队列的实现示意图,把worker分到别的机器上部署就是分布式任务框架了,感觉还挺牛逼的
应用侧开发体验是这样的
感觉还行
但是还有最后一个问题,开发者在开发时不知道哪些依赖是不兼容子解释器的,怎么办
那没办法,因为我也不知道,所以只能在运行时报错提醒:哪个依赖不兼容子解释器。开发者可以自己加白名单,加完白名单之后web容器退回到单线程运行模式;或者把不兼容的那部分移到队列任务worker上运行